
Landgericht Müncheni – trzyfazowy model analizy wykorzystywania danych w sprawie GEMA przeciwko Open AI
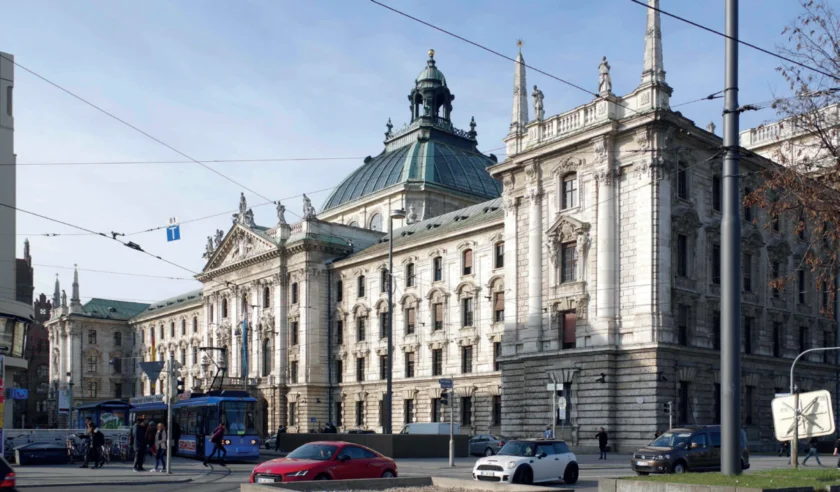
LG München w swoim wyroku z dnia 11 listopada 2025 r. (42 O 14139/24) rozpoznawał sprawę, która była śledzona przez prawie całą branżę IT oraz specjalistów od prawa na dobrach niematerialnych na całym świecie. Stronami sporu była GEMA (Gesellschaft für musikalische Aufführungs- und mechanische Vervielfältigungsrechte) oraz Open AI (organizacja badawcza zajmująca się sztuczną inteligencją, twórca ChatGPT). LG München orzekł jako pierwszy sąd w Europie, że ChatGPT naruszył prawa autorskie GEMA, z uwagi na zapamiętywanie („memoryzację”) chronionych utworów. Wyrok jest w dalszym ciągu szeroko komentowany w literaturze oraz stanowi istotny znak zapytania, co do rozwoju wynalazków opartych na sztucznej inteligencji w Europie.
Memoryzacja utworów
LG München uznał, że treści wykorzystywane jako dane treningowe mogą zostać zachowane w modelu językowym sztucznej inteligencji, a następnie ponownie odtworzone w generowanych przez niego odpowiedziach. Model językowy to system komputerowy, który został stworzony przy pomocy dużej ilości tekstów w różnych językach, na podstawie których może generować odpowiedzi na zadane pytania. Takim systemem jest ChatGPT. LG München stwierdził, że dane wykorzystywane do trenowania modelu językowego w postaci tekstów piosenek, linii melodycznych czy tembru głosu artysty są nie tylko przechowywane, ale również rozkładane na pojedyncze elementy. Z rozłożonych na czynniki pierwsze tekstów powstają odpowiedzi wygenerowane przez model językowy. LG München wyodrębnił trzy fazy działania OpenAI: przygotowanie zbioru treningowego, trening modelu oraz generowanie wyników (output). Do każdego etapu przypisano odrębną kwalifikację prawną na podstawie prawa autorskiego. LG München uznał, że proste prompty (czyli proste zadania) stanowią dowód memoryzacji (zapisywania treści), a nie warunek jej istnienia. Zapisywanie danych dokonuje się przy wprowadzeniu promptu każdego rodzaju. Prompt to pytanie lub zadanie, które zleca się modelowi językowemu. Należy zaznaczyć, że przed wydaniem wyroku przez LG München stanowisko w sprawie modelu trój etapowego zostało sformułowane przez LG Hamburg w sprawie LAION (wyrok z 27.9.2024 r., 310 O 227/23, Rn. 45–46). LG Hamburg wyodrębnił trzy etapy wykorzystywania danych w postaci tworzenia zbioru treningowego (etap I), który uznał za objęty ochroną prawem autorskim. LG Hamburg nie ustosunkował się do etapu drugiego oraz trzeciego (treningu modelu oraz generowania odpowiedzi). LG München rozszerzyło te rozważania.
Wyjątek zezwalający na korzystanie z utworów
Widmo naruszenia praw autorskich majątkowych może zostać zażegnane przez uzyskanie zgody od uprawnionego w postaci udzielania umowy licencyjnej (umowy o korzystanie z utworu). Zgoda nie jest wymagana, jeżeli czynność przetwarzania mieści się w wyjątku przewidzianym przez prawo autorskie. Podstawą wyjątku jest eksploracja tekstów i danych, uregulowana w art. 4 dyrektywy Parlamentu Europejskiego i Rady (UE) 2019/790 z 17.04.2019 r. w sprawie prawa autorskiego i praw pokrewnych na jednolitym rynku cyfrowym oraz zmiany dyrektyw 96/9/WE i 2001/29/WE (Dz.Urz. UE L 130, s. 92). Wyjątek został wprowadzony do niemieckiej ustawy o prawie autorskim w § 44b (Gesetz über Urheberrecht und verwandte Schutzrechte, BGBl. 2024 I Nr. 323).
W swoim wyroku LG München zwrócił uwagę, że samo wykorzystanie utworów w procesie trenowania modelu językowego nie wystarcza do uznania, że zwielokrotnienie utworów jest objęte wyjątkiem dotyczącym eksploracji tekstów i danych. Zwielokrotnienie musi być dokonane w celu prowadzenia takiej eksploracji. Istotnym elementem jest nie tylko stwierdzenie, że dane zostały zwielokrotnione podczas treningu modelu, lecz także wskazanie funkcji, jaką pełniło ich zwielokrotnienie. Sąd nie zgodził się na rozszerzenie tego wyjątku w drodze analogii. Przyczyną był brak korelacji z podobnymi stanami faktycznymi, które mogłyby uzasadnić stosowanie tego wyjątku.
Zdaniem LG München, wyjątek dotyczący eksploracji tekstów i danych został skonstruowany przy założeniu, że ingerencja w interesy podmiotów praw autorskich będzie miała jedynie ograniczony charakter. W przypadku zapisywania treści danych, ryzyko naruszenia tych interesów może wynikać ze sposobu działania modelu językowego sztucznej inteligencji. To ryzyko jest związane ze sferą działalności operatora modelu językowego, którym w omawianym wyroku jest OpenAI. W opinii sądu zamiar, jaki miał podmiot dokonujący zwielokrotnienia nie miał decydującego znaczenia przy stwierdzaniu naruszenia. Wskazanie, że utwór został zwielokrotniony na potrzeby eksploracji tekstów i danych, nie przesądza jeszcze o zastosowaniu wyjątku. Konieczne jest ustalenie, jaką rzeczywistą rolę miało zwielokrotnienie danych w procesie działania modelu językowego.
Konieczność zmiany stanowiska
Kwalifikacja memoryzacji danych jako zwielokrotnienia jest sporna. Brak zachowania elastyczności przepisów prawnych regulujących zapisywanie treści utworów przez modele językowe będzie stanowiło kamień milowy w rozwoju systemów sztucznej inteligencji w Europie. Należy wskazać, że liberalne stanowisko w sprawie memoryzacji, niekwalifikujące jej jako zwielokrotnienia, powinno być uznane za Sad krajowy w Monachium właściwe.
Dr Michał Barycki – Adiunkt w Instytucie Nauk Prawnych Uniwersytetu Śląskiego w Katowicach. Absolwent Szkoły Doktorskiej Nauk Społecznych Uniwersytetu Jagiellońskiego w Krakowie oraz Max Planck Institut für Innovation und Wettbewerb w Monachium. Specjalizuje się w prawie własności intelektualnej, w szczególności europejskim prawie patentowym, prawie autorskim oraz prawie konkurencji. Autor licznych publikacji naukowych w czasopismach polskich oraz zagranicznych.


